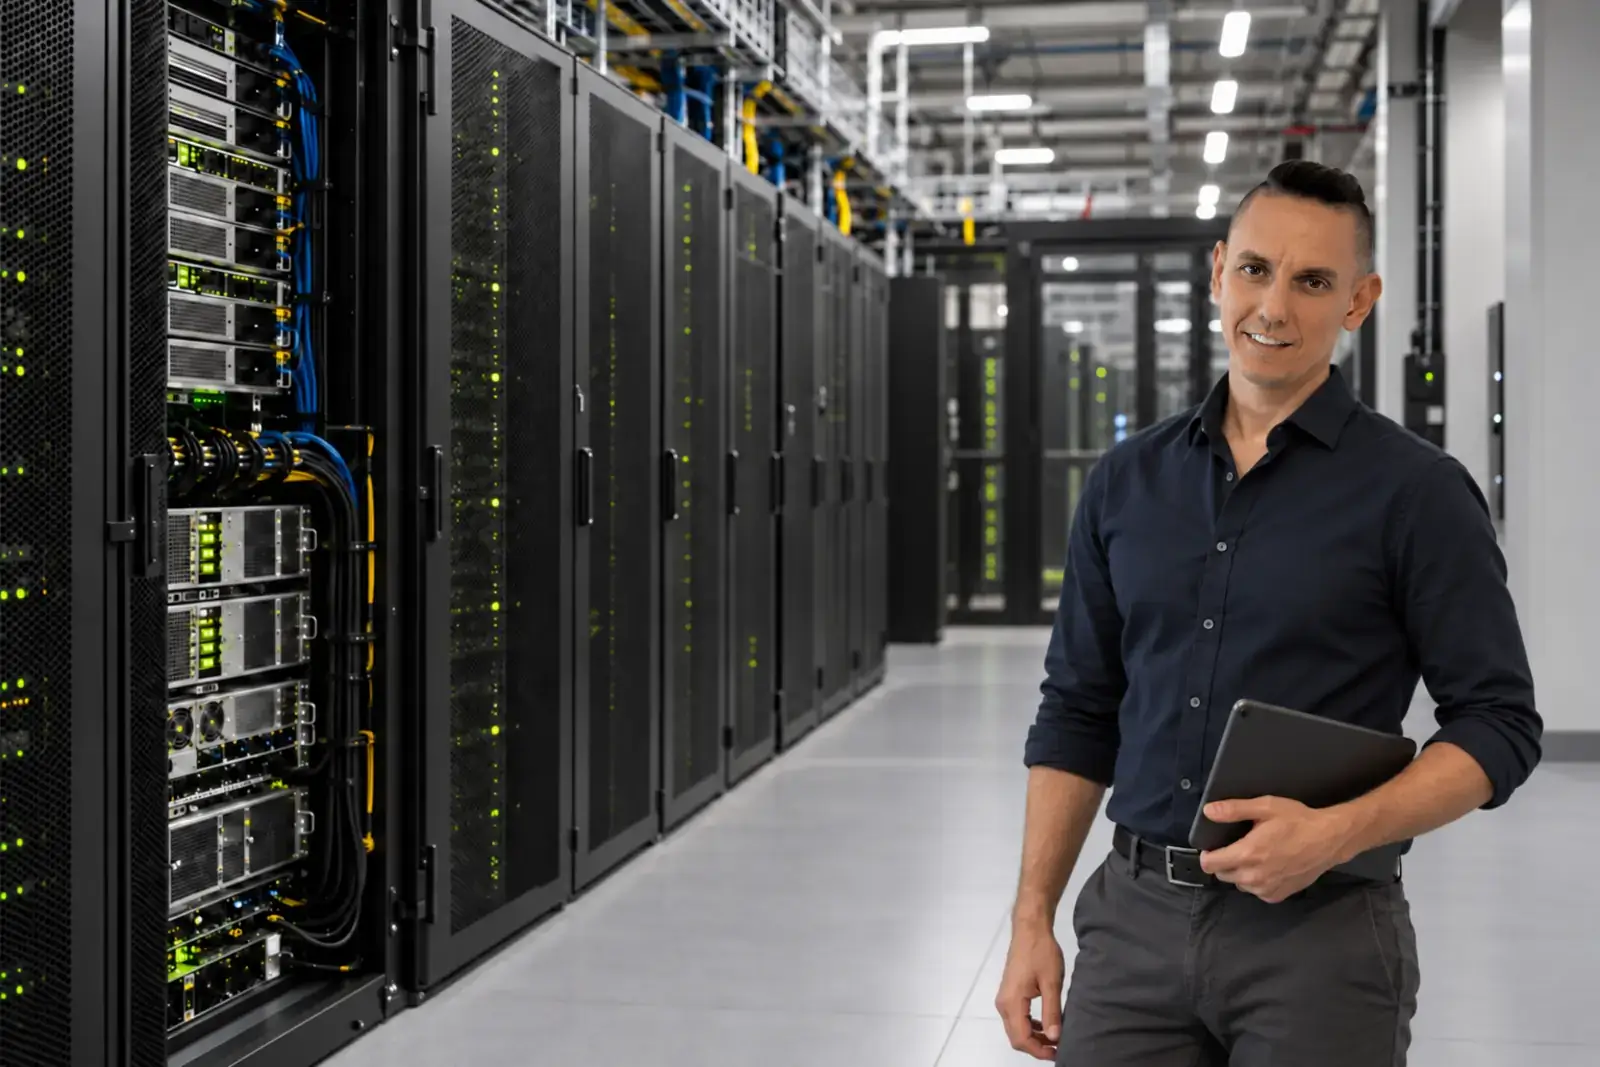
10 лет я держу две линии сразу: международные события и техническую часть. Техническая началась с серверов, майнинга и нод, сегодня это проектирование дата-центров под AI на GPU NVIDIA, площадки в ЕС и США и доступ к моделям через API, где экономия на инференсе составляет от 10 до 90% в зависимости от задачи. Два навыка сошлись в одной точке.
Ниже — что из фермы переносится в машинный зал, из чего складывается разброс от 10 до 90% и когда своё железо не нужно вообще.
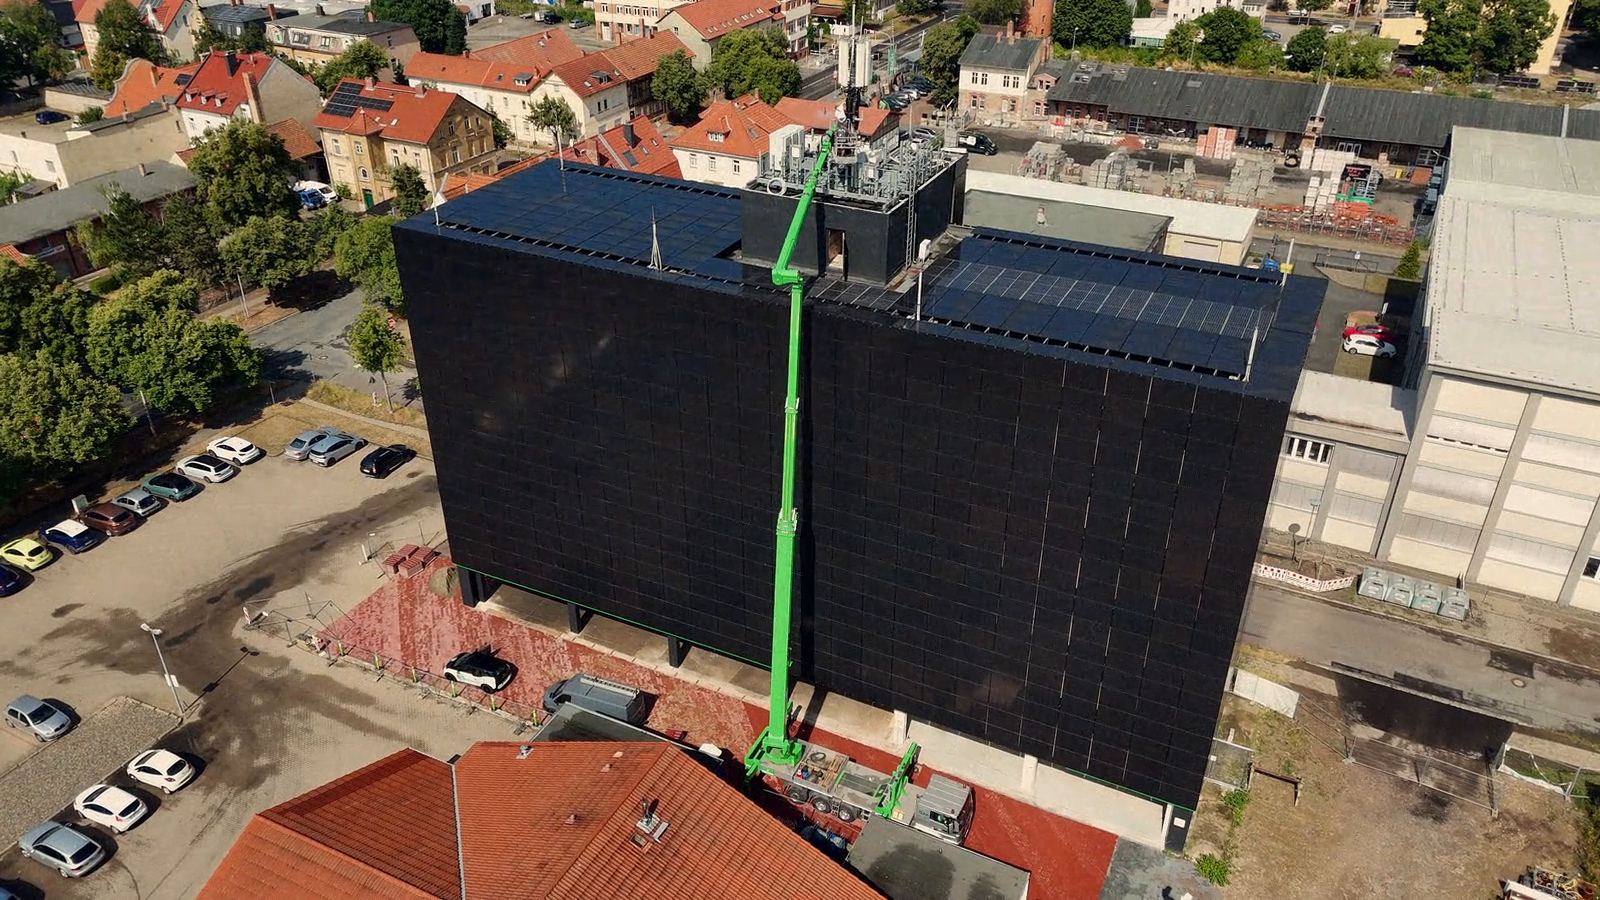
Техническая линия никогда не прерывалась
Эту часть биографии обычно не замечают, потому что снаружи видны конференции. Но серверы, майнинг и ноды шли параллельно событиям всё это время, просто они не попадают в новости.
Разница между двумя линиями в том, как считается результат. Событие живёт неделю, а его последствия квартал. Железо живёт годами, и ошибка в проекте площадки обходится не репутацией, а счетами за электричество каждый месяц.
Поэтому решения здесь принимаются медленнее. В событии неудачное решение можно переиграть на ходу, в площадке оно остаётся с вами на весь срок аренды и амортизации.
Ферма и машинный зал решают одни и те же задачи
Со стороны это разные миры: одни считали хеши, другие обучают и запускают модели. Инженерно задачи почти совпадают.
Питание и его стоимость. Охлаждение и то, как оно ведёт себя летом. Плотность стоек, которую площадка выдерживает без переделки. Логистика и сроки поставки железа. Эксплуатация в режиме 24/7, где простой стоит денег каждый час.
Люди, которые прошли майнинг, обычно знают то, чего нет в спецификациях: реальную стоимость киловатта в конкретной стране, срок, за который приходит партия, и что произойдёт с площадкой, если её собрать по минимальным требованиям. Именно эта часть опыта переносится в дата-центр под AI целиком.
Разница есть, и она существенная: у GPU другой профиль нагрузки и другие требования к сети между узлами. Но это надстройка над теми же основами, а не новая профессия.
Вторая часть опыта, которая переносится, — отношение к поставщикам. В майнинге срок поставки и реальные характеристики железа расходились с обещанными регулярно, и привычка проверять до оплаты, а не после, осталась.
Третья — считать не только закупку. У площадки есть стоимость владения: электричество, обслуживание, замена вышедших из строя карт, аренда. Я обычно начинаю разговор о проекте именно с неё, потому что цена железа в смете выглядит убедительно ровно до первого счёта за месяц работы.
Из чего складывается экономия от 10 до 90%
Разброс в диапазоне пугает, поэтому объясню, из чего он берётся. На стоимость инференса влияют четыре вещи:
- Выбор модели под задачу. Модель меньшего размера, которая решает конкретную задачу с нужным качеством, отличается по цене от универсальной в разы, а не на проценты.
- Режим работы. Пакетная обработка, где ответы не нужны мгновенно, стоит принципиально дешевле, чем отклик в реальном времени.
- Загрузка железа. Своя площадка выигрывает при ровной нагрузке и проигрывает при редких всплесках: карта, которая простаивает, всё равно стоит денег.
- Место в стеке. Иногда дешевле переписать промпт и убрать половину токенов, чем менять железо.
Отсюда и диапазон. Десять процентов — это аккуратная оптимизация задачи, которая уже хорошо устроена. Девяносто — случай, когда мощная универсальная модель в реальном времени заменяется связкой поменьше в пакетном режиме. Обычно правда лежит между этими полюсами, и почти всегда выигрыш складывается из трёх-четырёх мелких решений, а не из одного большого.
Считать это надо до переезда, а не после. Перенос нагрузки на другую связку занимает недели, и если экономия оказалась на уровне десяти процентов, эти недели не окупятся.
Когда своё железо не нужно
Доступ к моделям через API закрывает текст, изображения, видео и музыку без покупки оборудования. Для большинства продуктовых задач это правильный старт: пока нагрузка непредсказуема, платить за простаивающие карты незачем.
Своя площадка начинает выигрывать в двух случаях: когда нагрузка стала ровной и большой или когда данные нельзя выпускать за периметр. Всё, что между этими полюсами, решается арифметикой, а не убеждениями.
Есть и третий случай, про который вспоминают позже остальных: когда стоимость запроса становится частью юнит-экономики продукта. Пока инференс — это строчка в расходах на разработку, его не считают. Как только он попадает в себестоимость каждой продажи, разница между 10 и 90% перестаёт быть технической деталью.
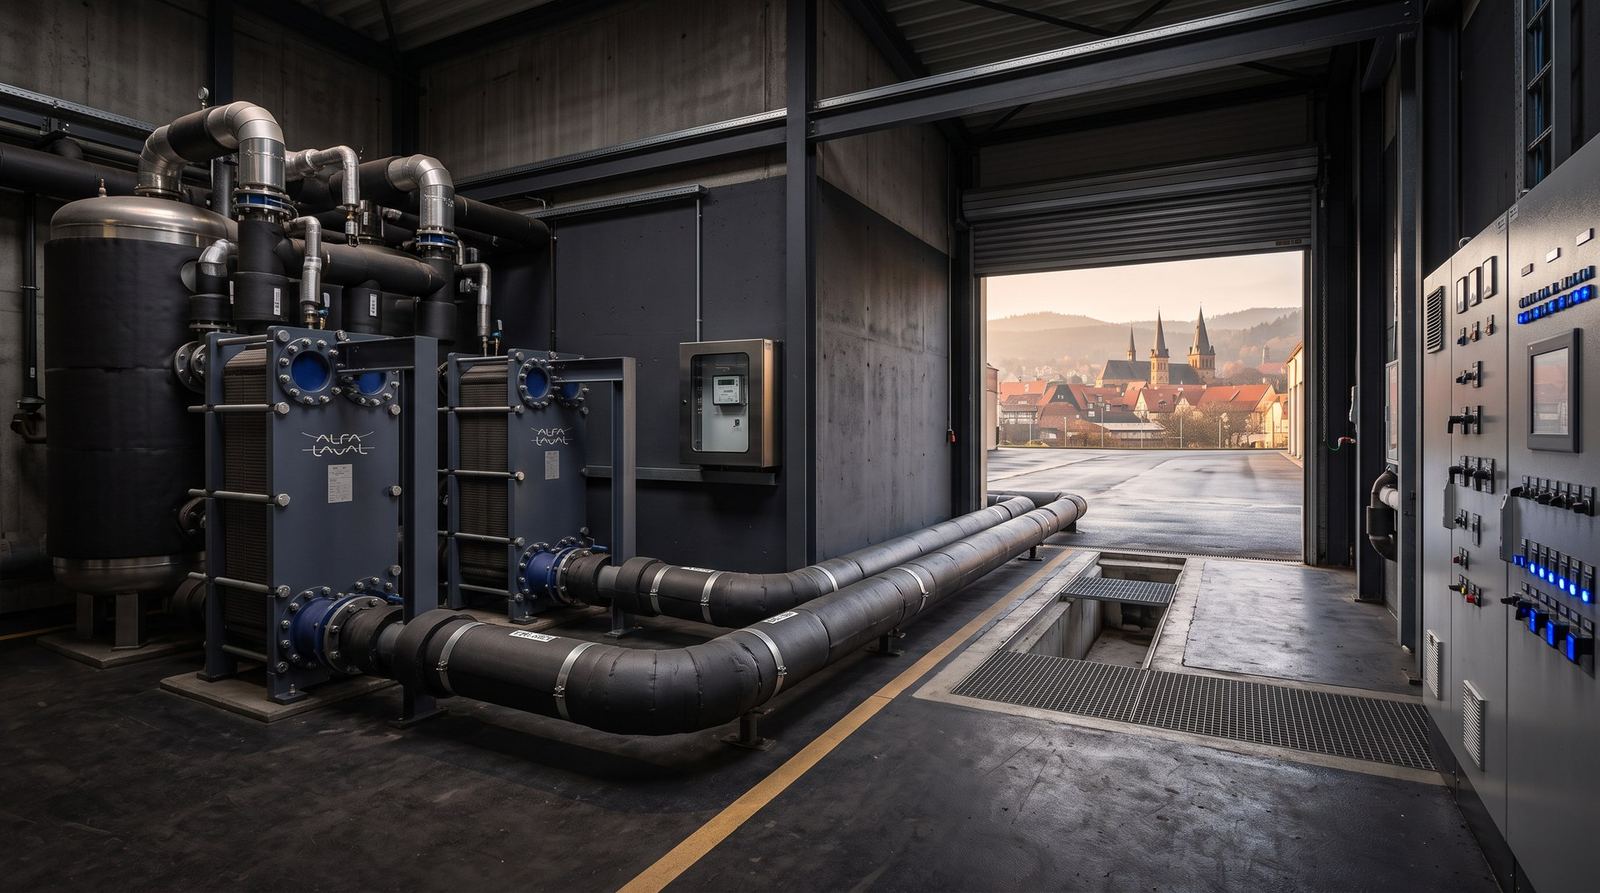
С чего начинается разговор о площадке
Ко мне обычно приходят с вопросом «сколько будет стоить». Ответить на него без четырёх вещей нельзя, поэтому разговор начинается с них.
Первое: какие задачи и в каком режиме. Обучение, дообучение и инференс — три разные истории с разными требованиями к железу. Второе: профиль нагрузки за месяц. Ровная кривая и всплески по вечерам дают разные схемы. Третье: требования к данным. Если их нельзя выпускать за периметр, часть решений отпадает сразу. Четвёртое: горизонт. Проект на квартал и проект на три года считаются по-разному.
Эти четыре ответа занимают один разговор, а экономят месяцы. Всё, что предлагается до них, — не предложение, а реклама.
Чего я не обещаю
Я не подрядчик вендоров и не перепродаю чужие обещания. GPU NVIDIA — это железо, на котором собираются площадки, а не партнёрство.
Не называю сроков окупаемости, пока не увидел профиль нагрузки: любая цифра до этого — маркетинг. И не даю «экономию до 90%» как оффер. Девяносто процентов бывает, но это результат конкретной переделки, а не свойство услуги.
Вопросы про железо и модели
Чем Сергей Петрик занимается в AI-направлении? Проектирует дата-центры под AI на GPU NVIDIA с площадками в ЕС и США, подбирает оборудование и даёт доступ к моделям через API: текст, изображения, видео, музыка. Экономия на инференсе в зависимости от задачи составляет от 10 до 90%.
Откуда взялся такой разброс в экономии? На стоимость влияют четыре вещи: размер модели под задачу, режим работы (пакетный или в реальном времени), ровность загрузки железа и организация самого запроса. Десять процентов дают аккуратные правки, девяносто — смена всей связки.
Что общего у майнинга и дата-центров, которые проектирует Сергей Петрик? Питание, охлаждение, плотность стоек, логистика железа и эксплуатация без простоев. У GPU другой профиль нагрузки и выше требования к сети между узлами, но основа площадки та же.
Когда выгоднее API, а когда своя площадка? API выгоднее, пока нагрузка неровная и непредсказуемая. Своя площадка выигрывает при постоянной высокой нагрузке или когда данные нельзя выпускать за периметр компании.
Можно ли обсудить с Сергеем Петриком проект площадки или доступ к мощностям? Да, через форму на сайте. Для разговора по существу нужны четыре вещи: тип задач, профиль нагрузки за месяц, требования к размещению данных и горизонт проекта. С ними ответ занимает один разговор, без них любая цифра будет рекламой.
Зачем организатору конференций дата-центры? Техническая линия у Сергея Петрика идёт параллельно событиям все десять лет, просто она не попадает в новости. Сегодня обе сходятся: проектам, которые он ведёт, нужны и аудитория, и вычислительные мощности.
Об авторе. Сергей Петрик десять лет ведёт параллельно две линии: международные события и вычислительную инфраструктуру. Сегодня это проектирование дата-центров под AI на GPU NVIDIA, площадки в ЕС и США, доступ к моделям через API, а также участие в проектах, где данные важнее железа, например в оцифровке юридической библиотеки университета имени Ярослава Мудрого в Харькове. Родился в Днепре, живёт в Дубае, ведёт проекты в трёх регионах. LinkedIn